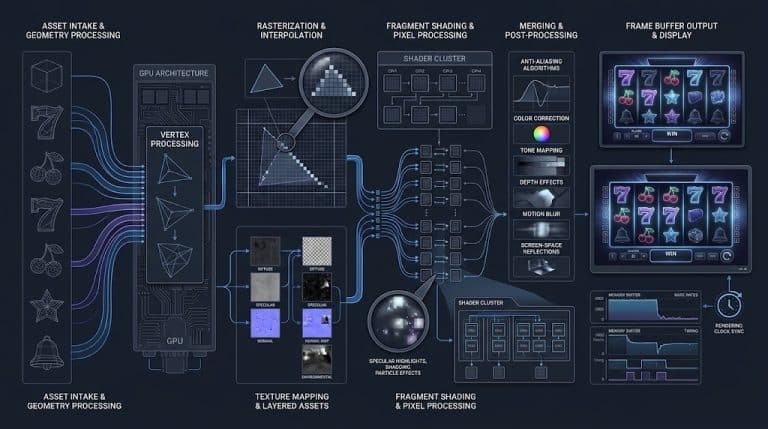
Di balik setiap putaran mesin slot digital yang mulus, terdapat komputasi intensif yang sering kali melibatkan miliaran operasi. Pemrosesan paralel adalah teknologi yang memungkinkan platform slot menangani beban kerja besar ini dengan membagi tugas ke banyak unit pemrosesan secara bersamaan. Kajian ini akan mengupas implementasi praktis pemrosesan paralel pada ekosistem slot modern. Berikut artikel ini akan membahas tentang Kajian implementasi pemrosesan paralel pada platform slot.
Konsep Dasar: Paralelisasi untuk Validasi dan Simulasi
Validasi RTP merupakan area utama yang membutuhkan pemrosesan paralel. Gaming Laboratories International (GLI), lembaga sertifikasi terkemuka, menjalankan 10 miliar iterasi simulasi untuk memverifikasi keadilan dan RTP sebuah permainan slot. Eksekusi ini dapat memakan waktu dari beberapa jam hingga dua minggu tergantung kompleksitas game, yang mendorong kebutuhan akan metode yang lebih cepat .
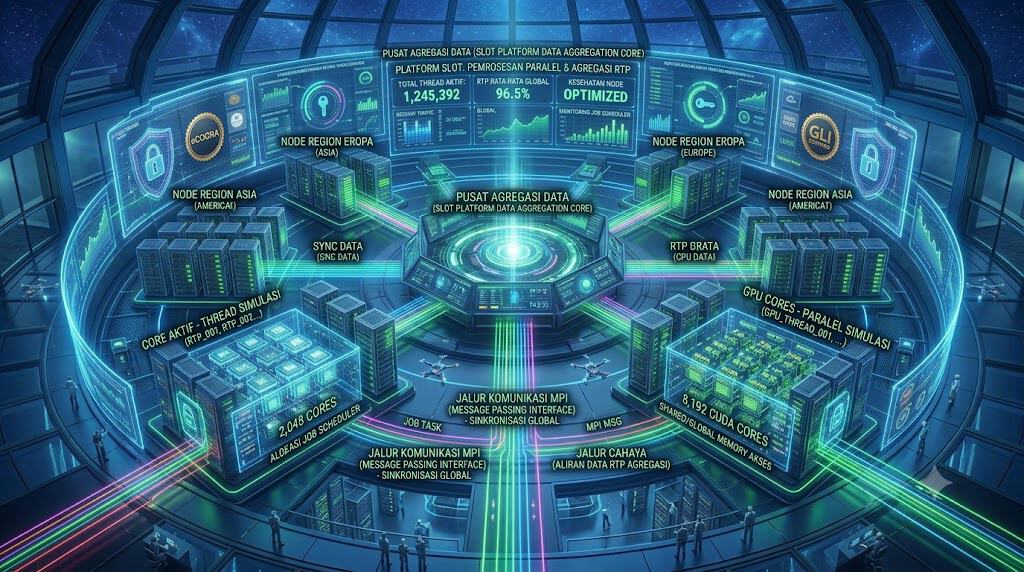
Simulasi slot pada dasarnya adalah tugas yang embarrassingly parallel, karena setiap putaran independen satu sama lain. Proyek GLI menunjukkan bahwa implementasi GPU mampu mempercepat simulasi secara dramatis melalui tiga pendekatan: CPU linear (brute force), CPU multithreaded, dan GPU dengan CUDA . Model ini menjadi tolok ukur bagaimana paralelisasi diimplementasikan di industri.
Model Paralelisasi: MPI, OpenMP, dan GPU
Dalam komputasi paralel, ada tiga model utama yang diterapkan pada pengembangan slot. Model MPI (Message Passing Interface) cocok untuk distributed jobs, di mana CPU tersebar di beberapa node komputasi. Model ini tidak memiliki batasan jumlah CPU, tetapi komunikasi antar-proses dapat menjadi hambatan .
Model Multi-threaded (OpenMP) menempatkan semua CPU pada node yang sama dan berbagi ruang memori bersama. Komunikasi antar-proses sangat efisien, tetapi terbatas pada jumlah CPU pada node terbesar. Penelitian GLI menunjukkan bahwa 16 thread adalah jumlah optimal untuk prosesor yang diuji, meskipun prosesor yang lebih canggih dapat memanfaatkan thread lebih banyak .
Model GPU (CUDA) menawarkan paralelisasi masif dengan ribuan core. Implementasi GLI pada Nvidia GeForce GTX 1080 menunjukkan bahwa penyimpanan variabel pada shared memory (40 KB) alih-alih global memory menghasilkan percepatan substansial. Penggunaan stack (DFS) daripada queue untuk traversing tree structure juga meningkatkan performa karena cache lebih efisien .
Slot Scheduling: Alokasi Sumber Daya Paralel
Pekerjaan paralel harus meminta sejumlah slot tertentu saat disubmit, dan jumlah slot yang dialokasikan diakses melalui variabel lingkungan NSLOTS .
IBM Spectrum LSF menyediakan mekanisme block allocation untuk meningkatkan performa. Misalnya, pekerjaan yang meminta 16 CPU dapat dialokasikan dalam kelompok 4 CPU per host (span[ptile=4]) atau dalam blok CPU sebanyak mungkin per host (span[block=4]). Alokasi blok ini meminimalkan komunikasi antar-node dan meningkatkan efisiensi .
Orkestrasi Visual dengan Eksekusi Paralel
Pada sisi frontend, pemrosesan paralel juga penting untuk animasi dan efek visual. Framework @dreams-engine/slot-flow mengimplementasikan pola perintah untuk mengorkestrasi animasi kemenangan. Runner dapat mengeksekusi perintah secara sekuensial atau paralel :
await runner.run([
  command1,                    // Sekuensial
  [command2, command3],        // Paralel
  command4                     // Sekuensial
]);
Pendekatan ini memungkinkan efek seperti dim, highlight, dan play win terjadi secara simultan, menciptakan pengalaman visual yang kaya tanpa jeda.
Optimasi RTP dengan MPI
Penelitian juga menunjukkan penggunaan paralelisasi untuk optimasi RTP. Proyek seperti SlotMachineBaseGameEvolutionaryOptimization mengimplementasikan optimasi evolusioner RTP dengan MPI (C++), sementara BingoSlotDifferentialEvolutionOptimization menggunakan differential evolution di C# . Pendekatan ini memungkinkan eksplorasi ruang parameter yang sangat besar secara efisien.
Kesimpulan
Implementasi pemrosesan paralel pada platform slot adalah upaya multidimensi yang mencakup simulasi validasi (GPU/CPU), alokasi sumber daya berbasis slot (job scheduler), orkestrasi visual (command parallelism), dan optimasi parameter (MPI). Strategi-strategi ini bekerja sinergis untuk mengurangi waktu pemrosesan dari minggu menjadi jam, memungkinkan pengembangan dan verifikasi game yang lebih cepat dan andal.